Project
公開中AI Problem-Solving Memory
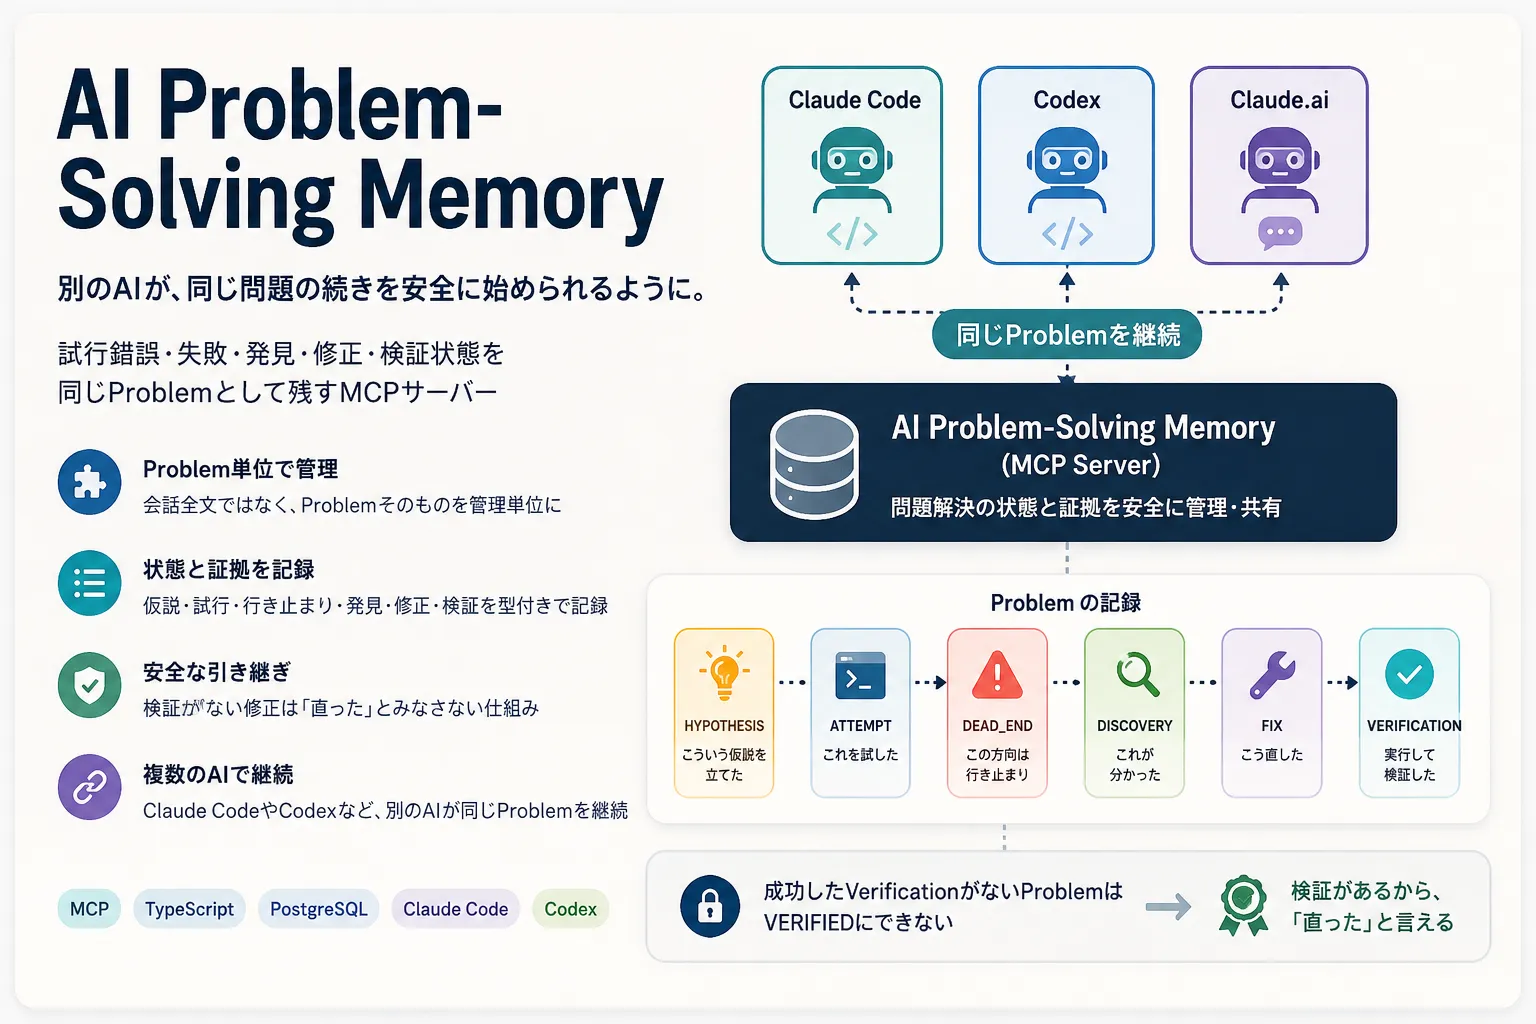
次に作業するのが別のAIでも、いま何が分かっていて、何はもう試してダメで、どこから続きを始めればいいかを判断できるProblem stateを残す——そのためのMCPサーバーです。
- MCP
- TypeScript
- PostgreSQL
- MIT License
なにをするもの?
人間があとで読み返すメモを残すことが目的ではありません。管理の単位は会話でもメモでもなく、Problem——「いま解こうとしている問題」そのものです。
別のAIが同じproblem_idを正規に継続して、前のAIの試行錯誤を判断材料として使えます。どのProblemに取り組んでいるかはAIの自己申告ではなくサーバーが権威を持ち、古い紐づけは使う直前に毎回再検証されます。
自動的に何でも記憶したり、会話を丸ごと共有したりはしません。「似た経験がありそう」と自動で判断して過去を引く仕組みもまだなく、記録も呼び出しも明示的です。
何を残す?
HYPOTHESIS
こういう仮説を立てた
ATTEMPT
これを試した
DEAD_END
この方向は行き止まりだった
DISCOVERY
これが分かった
FIX
こう直した
Verification
実際に何を実行して、成功したか失敗したか
FIXとVerificationは別の記録です。「直すコードを書いたこと」と「直ったことを確認したこと」は別物で、成功したVerificationがないProblemはVERIFIEDにできません。AIの「直りました」という宣言はVerificationではありません。
どこまで確認できている?
- Claude Code ↔ Codex — 同じProblemの継続を実環境で確認
- Claude Code → Claude.ai — remote MCP経由で同じProblemの継続を実環境で確認
- 上の2つは別々の確認で、3ホストを1本の連続チェーンで通したものではありません
- ChatGPTの書き込みまでの受け入れ確認は未完了(deferred)です
remoteのセッションは手元でテストを実行できないため、テスト実行のような「実行に接地した」種別のVerificationはサーバー側の入口が記録を拒否します。実行していない検証が記録されない設計です。
有料のAI APIは必須ではない
コアは有料のAI APIなしで成立します。Problemの管理、Event / Verificationの記録、状態遷移、そして保存された記録から決定的に生成した成果物への全文検索までは、外部providerなしで動きます。embeddingなどの意味ベース検索はoptionalで、providerがなくてもコアの検索は失われません。
現在地
技術的に動くこと——同じProblemを別のAIが継続できること、拒否すべきものを拒否すること——は確認済みです。ただし、普段の実開発で本当に便利なのかはまだ検証できていません。次に実際の開発で問題を踏んだときに本番投入して確かめる予定です。経緯と正直な現在地は開発記事にまとめています。
GitHub
ソースコードはMIT Licenseで公開しています。導入手順や設計の詳細はREADMEにまとめてあります。