目次
個人サイト「ぽいもの本舗」を公開した直後、Google Search Consoleへサイトマップを登録した。
ところが、結果は「サイトマップを読み込めませんでした」。
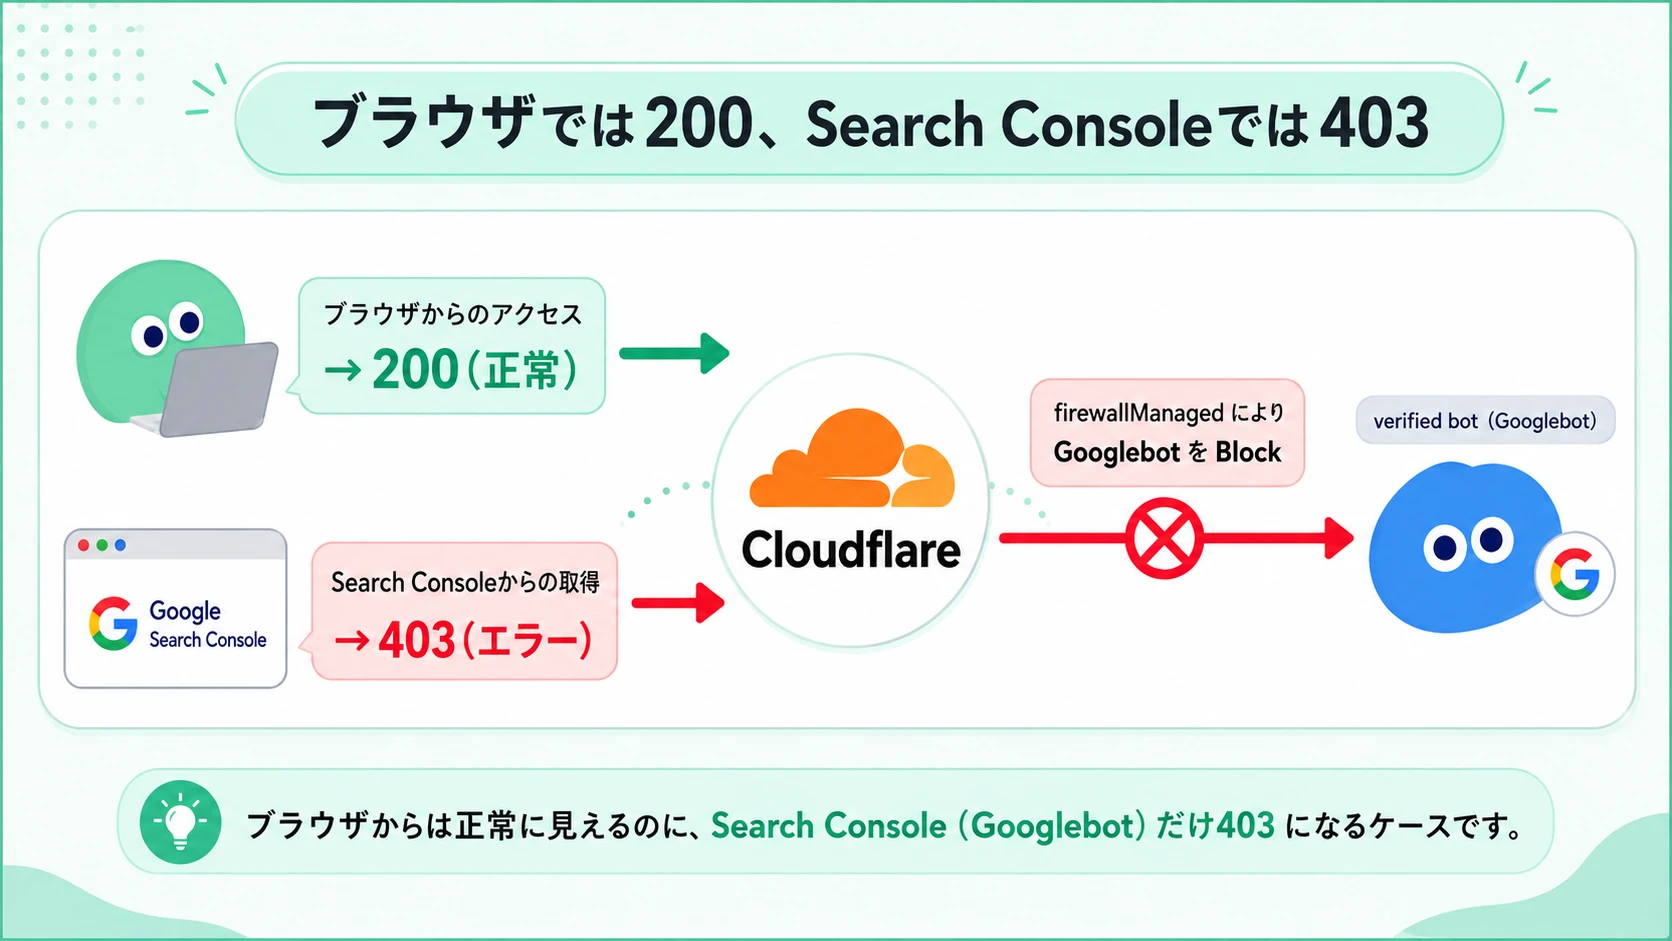
返っていたHTTPステータスは403だった。
少し厄介だったのは、ブラウザから同じサイトマップを開くと正常に表示できたことだ。
サイト自体も普通に閲覧できる。robots.txt もサイトマップも公開されている。
それでもGoogleからのアクセスだけが通らない。
調べてみると、原因はCloudflareで設定していたAI Bot Policyにあった。
ブラウザでは200、Search Consoleでは403
対象のサイトマップは次のURL。
https://poimono.jp/sitemap-index.xml
自分のブラウザからアクセスすると正常に表示される。
その一方で、Search Consoleから取得させると403になる。
最初に疑ったのは、
- sitemapの生成ミス
- Cloudflare Workers Static Assetsの配信設定
- robots.txt
- DNS
- Search Console側の一時的な問題
あたりだった。
しかし、どれも決定的な異常は見つからない。
CloudflareのログにはGooglebotの403が残っていた
そこでCloudflare側のリクエストログを確認したところ、Googleからのアクセスが実際にCloudflareまで到達していることが分かった。
しかも、単にGooglebotを名乗るアクセスではなく、Cloudflare側でverified botとして扱われるGooglebotだ。
対象には、
//robots.txt/sitemap-index.xml/sitemap-0.xml
などへのリクエストが含まれていた。
そして、それらが firewallManaged によってBlockされ、HTTP 403になっていた。
つまり問題はSearch ConsoleでもAstroでもない。
GooglebotはCloudflareの手前で遮断されていた。
原因はAI Bot Policyの「Training = Block」
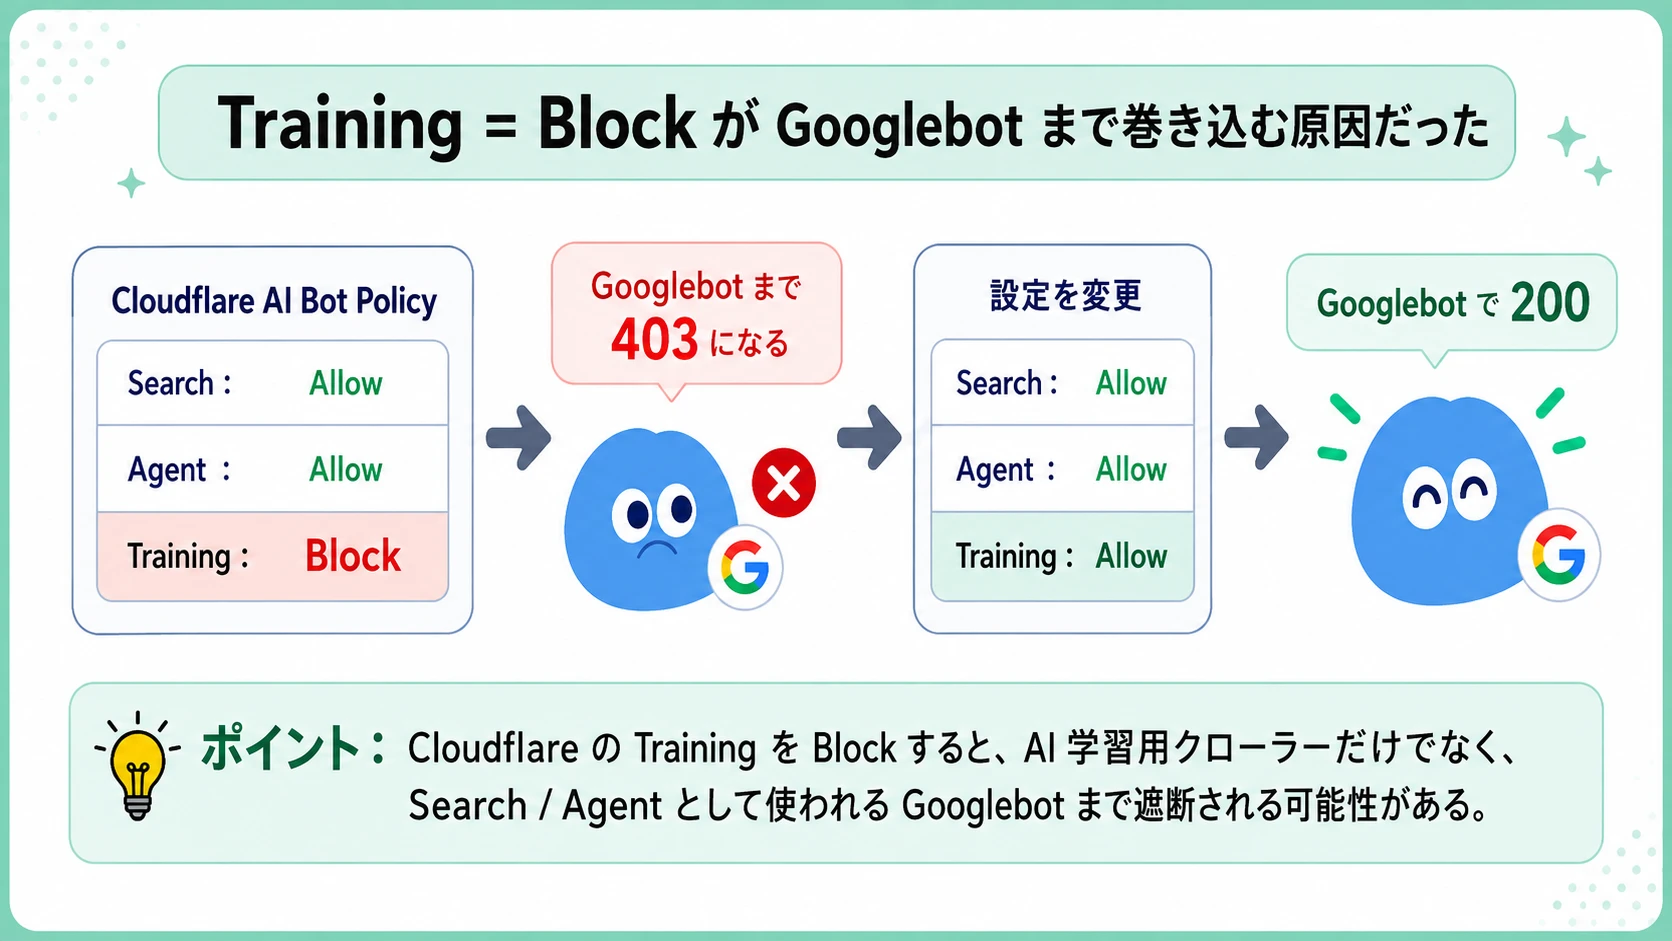
当時のCloudflare AI Bot Policyは次の設定だった。
- Search: Allow
- Agent: Allow
- Training: Block
意図は、検索エンジンのクロールを許可しつつ、AIモデルの学習用途だけを拒否することにある。
そのため「Searchを許可してTrainingだけBlockすればいい」と考えていた。
ところが、この理解には落とし穴があった。
Cloudflareは現在、AI関連のbotをSearch / Agent / Trainingといった「用途」で分類している。
さらにTrainingには、学習だけを目的とするcrawlerだけでなく、SearchとTrainingの両方で使われるmixed-purpose crawlerも含まれる。
Cloudflareの公式ドキュメントにも、Trainingのブロック対象にはmixed-purpose crawlerが含まれると明記されている。
今回の環境では、この分類と設定の組み合わせによってverifiedなGooglebotまでBlockに巻き込まれていた。
Googlebot自体を「AI学習専用crawler」と考えるべきではない。
重要なのは、Cloudflare側の挙動分類と設定によって、検索に必要なcrawlerまでネットワークレベルで遮断され得るという点だ。
サイトマップだけの問題ではなかった
最初に表面化したのは、Search Consoleのサイトマップエラーだった。
しかしログを見る限り、影響はサイトマップに限られていなかった。
通常ページへのGooglebotアクセスも403になっている。
つまり、このまま放置すると、
「サイトマップを登録できない」
だけではなく、
「Googleがサイトそのものを正常にクロールできない」
状態になる可能性がある。
公開直後に気付けたのは幸いだった。
TrainingをAllowへ戻した
最終的にCloudflare側の設定は次の状態に変更した。
- Search: Allow
- Agent: Allow
- Training: Allow
ネットワークレベルではGooglebotを含むcrawlerを止めない。
その代わり、AI学習への利用を拒否する意思表示は robots.txt 側へ移した。
現在の robots.txt では、たとえばContent Signalsとして
search=yes, ai-train=no
を表明している。
CloudflareのManaged robots.txtも、AI crawlerに対する利用方針を表明する仕組みとして提供されている。
ここで注意したいのは、robots.txtはネットワークレベルのアクセス制御ではないこと。
Cloudflareの説明でも、robots.txtへの準拠はcrawler側の任意であり、アクセス自体を技術的に禁止するものではない。
それでも今回は、
「Google Searchに必要なcrawlerまで止めるリスク」
と
「AI学習への利用拒否を表明すること」
を分離する方を選んだ。
Google-ExtendedはGoogle Searchとは別
Googleについては Google-Extended もrobots.txtで拒否している。
ここはGooglebotと混同しない方がいい。
Googleの公式ドキュメントによれば、Google-ExtendedはGoogle Searchへの掲載を制御するためのcrawlerではない。
Google-Extendedをrobots.txtで拒否しても、Google Searchへの掲載やランキングには影響しないと案内されている。
「Google関連だから全部許可する」「全部拒否する」とまとめるのではなく、用途ごとに分けて考える必要がある。
設定変更後、Googlebotは200になった
TrainingをAllowへ変更した後、Cloudflareのログをもう一度確認した。
今度はverifiedなGooglebotから、
//robots.txt/sitemap-index.xml/sitemap-0.xml
へのアクセスが200で通っている。
Search Consoleからサイトマップを再送信すると、ステータスも「成功しました」に変わった。
原因と解決策が一致したことで、今回の403はCloudflareのAI Bot Policyによるものだったと判断できた。
「AIをBlockする」と「検索botを守る」は別問題
今回の失敗は、設定項目の名前だけを見れば起こりやすいと思う。
「Search = Allow」 「Training = Block」
と並んでいれば、
検索は通し、AI学習だけ止められるように見える。
しかし実際のbot分類は、それほど単純ではない。
1つのcrawlerが複数の用途に分類されることもあり、TrainingをネットワークレベルでBlockすると、意図していなかったcrawlerまで影響を受ける可能性がある。
Cloudflare自身も、botを単一の「AI bot」というラベルではなく、行動や用途で分類している。
設定するときは、
「このスイッチの名前は何か」
ではなく、
「この設定によって、実際にはどのリクエストがBlockされるのか」
まで確認した方がいい。
Search Consoleで403が出たらCloudflare側も確認する
Cloudflareを使っているサイトで、
- ブラウザからは開ける
- sitemapも正常
- robots.txtにも問題がない
- それでもSearch Consoleでは403
という状態になった場合、Cloudflare側のbot / WAF設定は確認候補になる。
特にAI crawler関連の設定を変更している場合は、verified botのログまで見た方が早い。
今回も、ブラウザからサイトマップを眺めているだけでは原因には辿り着けなかった。
実際にGooglebotがどこで止められているのかをログで確認したことで、ようやく設定まで絞り込めた。
なお、このログ確認にはClaude CodeとCloudflare API MCPを使っている。導入の経緯は別の記事にまとめている。
CloudflareのAI関連機能は今も変更が続いている。
この記事を書いている2026年8月時点でも、AI botの分類やデフォルト設定に更新が入っているため、同じ問題を調べる場合は最新の公式ドキュメントも確認してほしい。
今回の教訓はシンプルだった。
「AI TrainingをBlockしたから、検索には影響しない」とは限らない。
検索に必要なcrawlerを守りながらAI利用方針を設定するなら、分類と実際のログを確認した上で、ネットワーク制御とrobots.txtを分けて考える必要がある。