Project
公開中Jev Voice Decision
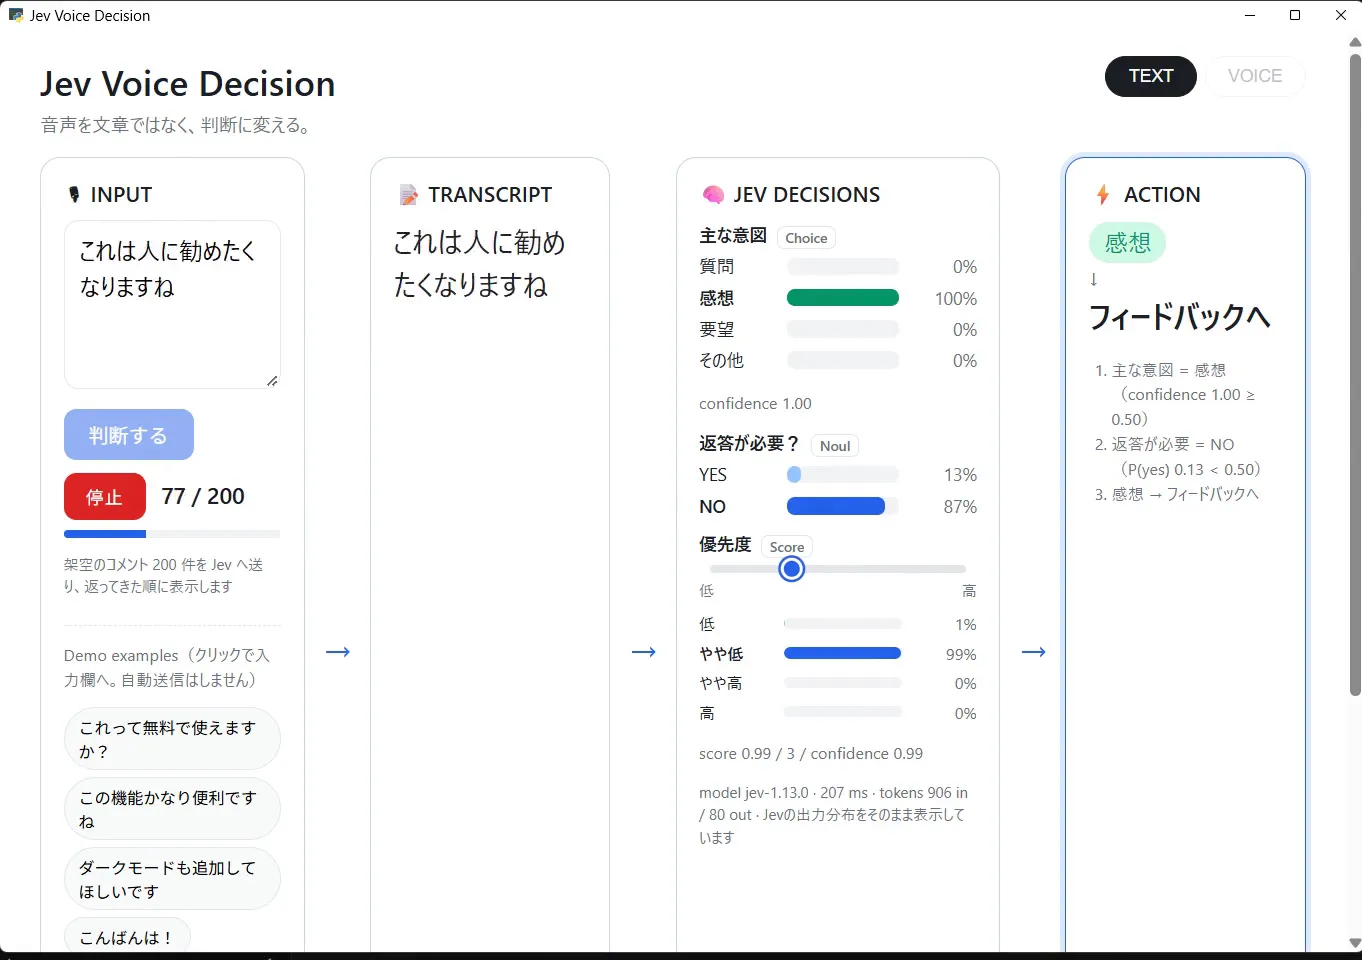
日本語音声 → ローカルSTT → Jevによる型付き判断 → Python処理。文章を生成しないAI「Jev」の判断を、普通のコードの分岐にそのまま使う様子を一画面で見せるデモです。
- Python
- Parakeet JA
- Jev / TypeSafe
- pywebview
- MIT License
なにをするもの?
マイクで話した日本語をPCの中のSTT(NVIDIA Parakeet JA)で文字にし、その文字起こし結果だけをTypeSafeのモデル「Jev」に送ります。Jevは文章ではなく、用意した選択肢や尺度に対する判断を確率つきで返すモデルです。
返ってきた判断をどう扱うかは、AIではなくPythonに書いた規則が決めます。質問で返答が必要なら質問キューへ、要望なら要望リストへ、感想ならフィードバックへ。同じ判断が入れば、必ず同じアクションになります。
音声そのものは外に送らず、音声も文字起こしもJevの応答も保存しません。題材は架空のライブ配信のコメントです。
Jevに聞いている3つのこと
主な意図(Choice)
質問・感想・要望・その他のどれか。全選択肢の確率分布と確信度が返ります
返答が必要か(Noul)
「はい」である確率が0〜1で返ります
優先度(Score)
4段階の状況記述のどこか。確率で重みづけした位置と各段階の確率分布が返ります
主な意図の確信度がデモ用の閾値を下回ったときは、アクションを決めずに判断保留として手動確認へ回します。分からないときに無理に決めない、という扱いをコード側で持てるのがJevの出力の特徴です。
Rapid Demo
架空の日本語コメント200件を続けてJevへ送り、判断とアクションが次々に切り替わる様子を見せるモードもあります。結果は事前に用意せず、毎回実際のAPIへ送ります。約30秒の紹介動画はGitHubのReleaseに置いています。
現在地
Text ModeとVoice Mode、Rapid Demoまで動く状態で公開しています。作った経緯と、Jevを使ってみて分かったことは開発記事にまとめています。
GitHub
ソースコードはMIT Licenseで公開しています。動かし方と設計はREADMEにまとめてあります。