目次
TypeSafeが公開している「Jev」は、同社がSystem One Modelと呼ぶ種類のAIモデルだ。ChatGPTやClaudeのように文章を返すのではなく、こちらが用意した選択肢や尺度に対する判断だけを返す。答えは文章ではなく、選ばれた選択肢と確率分布、それに確信度がついた構造化データとして戻ってくる。System One ModelというのはTypeSafeの呼称で、Jevはその最初の公開モデルとして2026年9月14日に公式ブログで発表された。
文章を書かないAIに何ができるのか、正直なところ最初はよく分からなかった。分からないなら動かしてみるのが早い。日本語の音声を手元のPCで文字にして、それをJevに渡し、返ってきた判断を普通のPythonのコードで処理する。そういう小さなデモを作ってみた。
この記事は、その「Jev Voice Decision」というデモを作った記録になる。コードはGitHubで公開している。
Jevは「答えの文章」ではなく「判断」を返す
Jevに投げるものは2つある。判断してほしい対象(TypeSafeの用語ではstate)と、それに対する質問だ。質問には3つの型があって、それぞれ返ってくるものが決まっている。
| 質問の型 | 聞き方 | 返ってくるもの |
|---|---|---|
| Choice | 用意した選択肢のどれか | 選ばれた選択肢、全選択肢の確率分布、確信度(confidence) |
| Score | 順序のある段階のどこか | 確率で重みづけした位置、各段階の確率分布、確信度 |
| Noul | この文は真か | 「はい」である確率(0〜1) |
たとえば「この発話の主な意図は、質問・感想・要望・その他のどれか」と聞けばChoiceで、「この発話への対応の優先度はどの段階か」と聞けばScoreで、「返答は必要か」と聞けばNoulになる。3つの質問を1回の呼び出しにまとめて送ることもできて、それぞれ独立に評価される。
面白いのは、出力に自由記述の余地がないことだ。選択肢の外の答えは返ってこないし、確率分布は全部足すと1になる。文章を生成するモデルでよく問題になる「それらしい回答文を後から解析する」という工程がそもそも存在しない。コードから見れば、返ってきた値をそのままif文に使える。
作ったもの:音声 → テキスト → 判断 → アクション
デモの流れはこうだ。
- マイクで日本語を話す(push-to-talk。常時聞き取りはしない)
- PCの中のSTT(NVIDIA Parakeet JAをNeMoで動かしたもの)で文字にする
- 文字起こし結果だけをJevに送り、3つの判断を受け取る
- 普通のPythonのコードが、その判断からアクションを決める
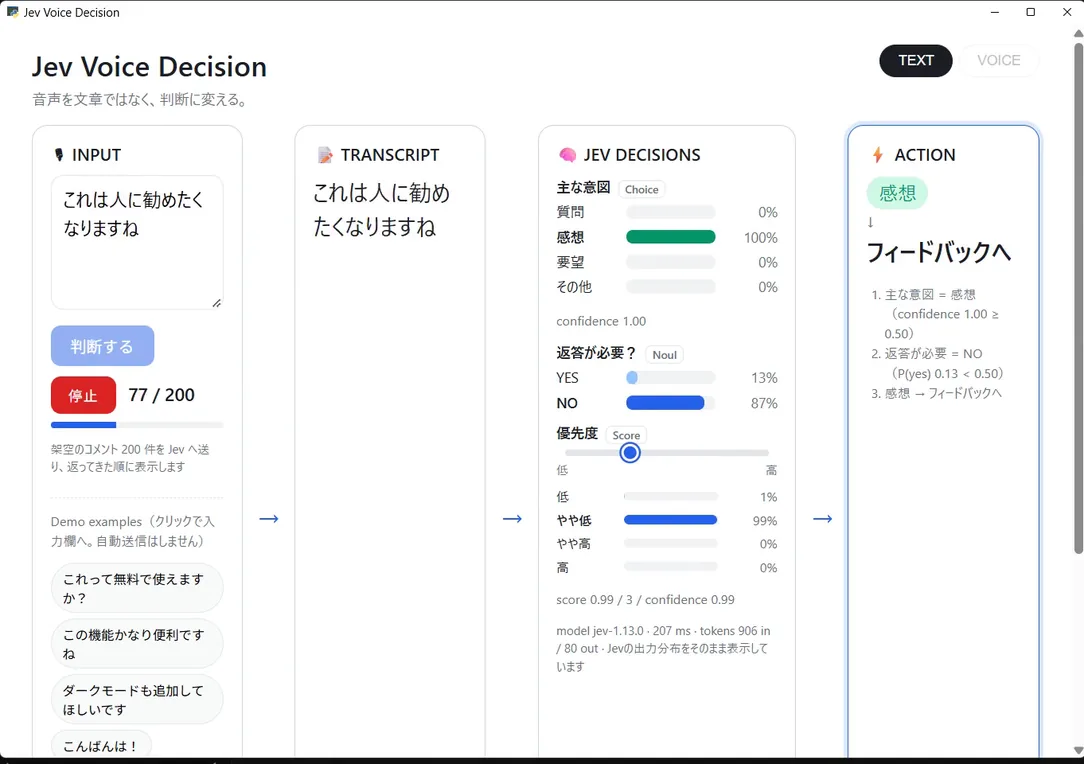
画面には、INPUT → TRANSCRIPT → JEV DECISIONS → ACTIONの4枚のカードが横に並んでいて、処理が進むたびに光るカードが右へ移っていく。
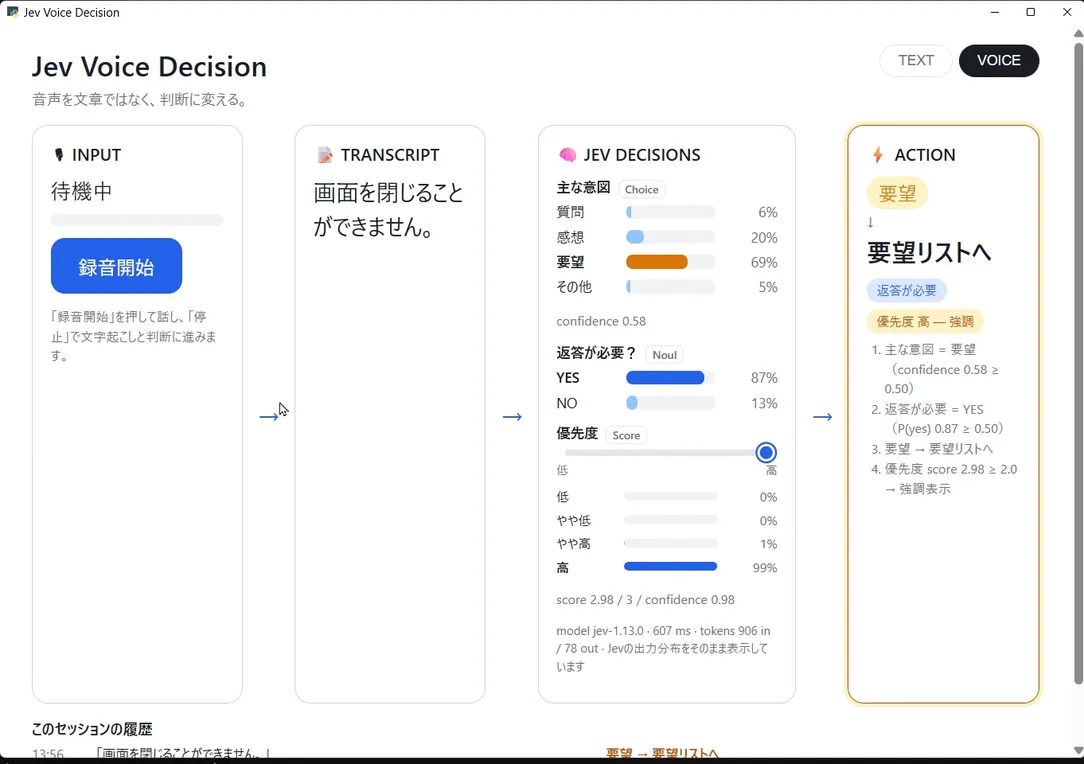
これは実際に自分の声で試したときの画面で、「画面を閉じることができません」と話した結果だ。意図は要望、返答は必要、優先度は高、という判断が返り、Pythonの規則で「要望リストへ」に振り分けられている。
音声そのものはJevに送らない。STTは端末内で完結していて、外に出るのは文字起こし結果と「配信のコメントである」という最小限の文脈だけにしている。音声も文字起こしもJevの応答も、どこにも保存しない。
題材は、架空のライブ配信に届くコメントにした。質問には答えたいし、要望は後で見返したい、感想は嬉しいだけで返事はいらない、といった扱いの違いがあって、判断を分岐に使う例としてちょうどよかった。実在の配信や発言とは関係のない、全部作った文章で動かしている。
判断はAI、決めるのはPython
このデモでいちばん大事にしたのは、Jevは判断だけをして、アクションは決定的なコードが決めるという分担だ。
Jevからは「主な意図」「返答が必要か」「優先度」の3つが確率つきで返ってくる。それをどう扱うかは、actions.pyという小さなファイルに普通の規則として書いてある。
- 質問で、返答が必要 → 質問キューへ
- 質問だが、返答は不要 → 記録のみ
- 要望 → 要望リストへ
- 感想 → フィードバックへ
- その他 → 記録のみ
- 優先度の値が一定以上 → 画面で強調
この規則にはAIが関わらない。同じ判断が入れば、必ず同じアクションが出る。Jevの出力は確率的で、Pythonの側は決定的。境界をここに引いておくと、「なぜそのアクションになったのか」を画面にそのまま並べられる。実際、ACTIONのカードには適用された規則が1行ずつ表示されるようにした。
閾値はコードの中に「デモ用の値」として明示してあるだけで、調整して最適化したものではない。確率分布と確信度はJevが返した値をそのまま出していて、精度や正解率のような数字は画面にもこの記事にも載せていない。
分からないときは決めない
Choiceには確信度がついてくる。確率分布が1つの選択肢に集中していれば高く、いくつかの選択肢に散っていれば低い。
この値がデモ用の閾値(0.5)を下回ったときは、アクションを決めずに判断保留として止め、「手動確認」に回すようにした。
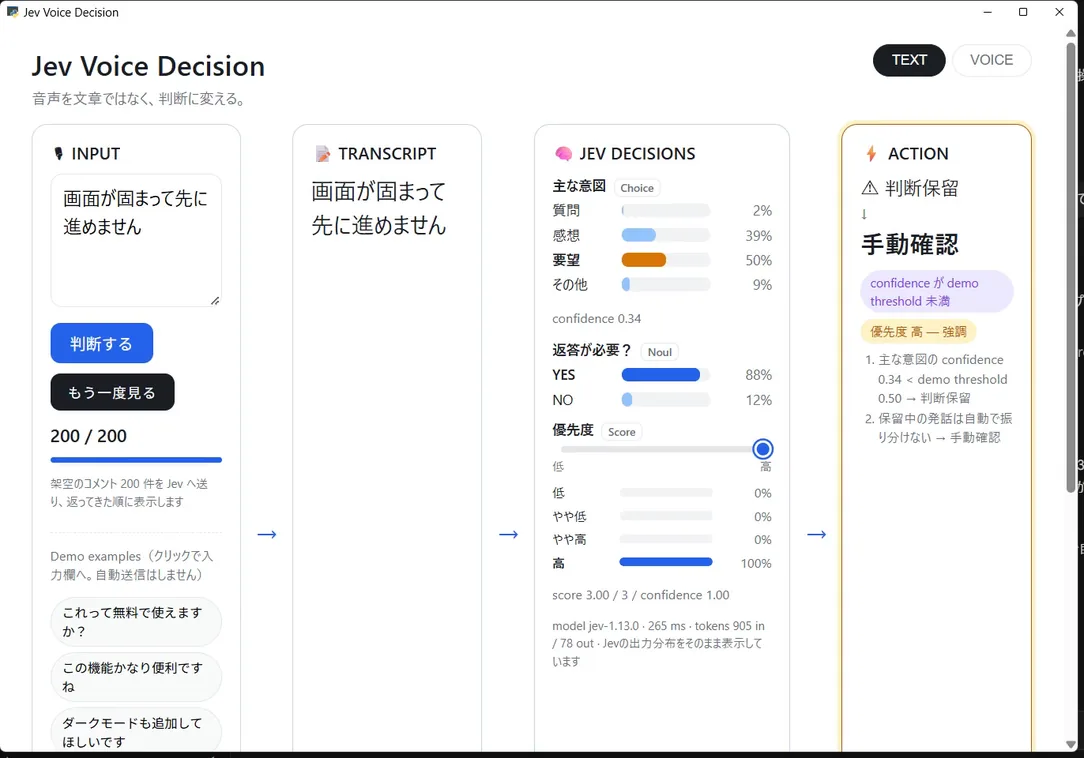
「画面が固まって先に進めません」という文は、要望が50%、感想が39%と割れて、確信度は0.34だった。困っている報告なのか、直してほしいという要望なのか、文だけでは決めきれない。こういうときに無理やりどちらかへ振り分けるより、人に回すほうが安全だと思う。
確率分布が丸ごと返ってくるので、「決めない」という選択肢をコードの側で持てる。文章を返すモデルだと、迷っていても文章は出てきてしまうので、この扱いは作りにくい。
Rapid Demo:架空の日本語200件を続けて判断させる
判断が次々に切り替わる様子を見せたくて、架空の日本語コメント200件をJevに送るモードも付けた。質問・感想・要望・挨拶・緊急っぽい報告・どっちつかずの発話をまぜてある。
結果は事前に用意せず、ボタンを押すたびに実際のAPIへ送る。同時に送る件数は上限を決めてあり(既定で12件)、レート制限の応答があれば新規送信を止めて同時数を下げる。返ってきた順に画面へ流れていくので、意図の色分けとアクションが目まぐるしく入れ替わる。
自分の環境で走らせたときは、200件すべてが返ってきて、エラーもレート制限もなかった。ただしこれは1回の実行の様子であって、速さや正確さを測ったものではない。そういう数字はこのデモの目的ではないので、画面にも出していない。
音声での実演から、200件の連続判断、判断保留までを約30秒にまとめた動画は、GitHubのReleaseに置いている。上の埋め込みは同じファイルで、実際の画面録画で、速度は変えていない。
JevのWaitlistとAPIキー取得
JevのAPIキーはTypeSafeのコンソールから取得するが、書いている時点ではWaitlist制だった。用途などを入力して申し込むと、自分の場合は約20時間後にアカウントを作成できるようになった。これは自分の一例で、全員が同じ時間で通るとは限らない。
Python SDKはtypesafe-sdkという名前で公開されていて、環境変数にAPIキーを入れておけば、クライアントを作って質問を渡すだけで使える。3つの質問の書き方や返ってくる型は公式ドキュメントに整理されているので、実装で迷うところは少なかった。今回の開発はClaude Codeと一緒に進めていて、公式ドキュメントの確認からSDKの実際の挙動の裏取りまで、そちらに任せた部分が大きい。
まとめ
Jevは文章を書かない。用意した選択肢と尺度に対する判断を、確率と確信度つきで返すだけだ。最初はそれが物足りなく思えたのだけれど、作ってみると、この「だけ」が使いやすかった。
返ってきた値をそのまま分岐に使えて、迷っているときは迷っていると分かり、決めないという扱いをコードで書ける。AIが判断して、決めるのは人間が書いた規則、という分担がはっきりする。
日本語音声をローカルで文字にして、その先の「どう扱うか」だけをAIに聞く。今回のデモはそれを一画面で見せるところまでで、この先どこに使うかはまだ決めていない。ただ、文章を生成しないAIの使いどころが、自分の中でひとつ具体的になった。
コードはjev-voice-decisionとしてGitHubに公開している(MIT License)。