目次
クラウドソーシングで自分にも受けられる仕事はないかと探し始めたのが、そもそもの発端だった。
CrowdWorksやLancersを眺めていると、Excelの統合や転記、CSVの整形といった作業が思っていたよりずっと多く募集されている。その中には、PDFやスキャンされた帳票をExcel / CSVへ変換する案件も混ざっていた。数十ページならまだしも、数百ページを手で打ち直すのは現実的ではない。
自分がExcel操作に詳しくなって全部を手でこなすより、面倒な部分を肩代わりしてくれる道具を先に用意したほうが早いのではないか。そう思って作り始めたのが、Excel / CSVの処理ツールだった。
ところが市場を調べていくうちに、PDFに対応しなければ、募集のなかでかなり大きな割合を占める案件を取りこぼすことが分かってきた。最終的には、スキャンされた帳票をOCRで読み取ってExcel / CSVへ変換するところまで広げることになった。
作り始める前にひとつだけ決めていたことがある。読み取りから出力まで、全部このPCの中で終わらせるというものだ。扱うのは他人の帳票で、取引先名も金額も入っている。それをどこかのサーバーへ送らずに済む形にしておきたかった。
この記事は、その道具をどう作ったのか、途中で何を間違えたのか、そして作り終えてから市場をもう一度調べて何を感じたのかの記録になる。
最初はExcel / CSVの処理ツールだった
作り始めた時点では、PDFのことなどまったく考えていなかった。頭にあったのは、募集でよく見かける次のような作業だ。
- 複数のExcelファイルを1つにまとめる
- 台帳から個票へ転記する
- CSVの列名や並び順を、別システムの取り込み形式に合わせる
どれも「高度なExcel機能」を求められるわけではなく、大量・反復・確実さのほうが価値になる種類の仕事だった。想定していた使い方も、受注した作業をこちら側で処理して成果物だけを返すというものだったので、相手のExcel環境に依存する仕組みにする理由がない。自分のPCだけで完結するGUIのデスクトップアプリとして、Windows向けの.NET 8 / WPFで作り始めた。Microsoft Excel自体がインストールされていなくても動くよう、ファイルはOpen XML SDKで直接読み書きしている。
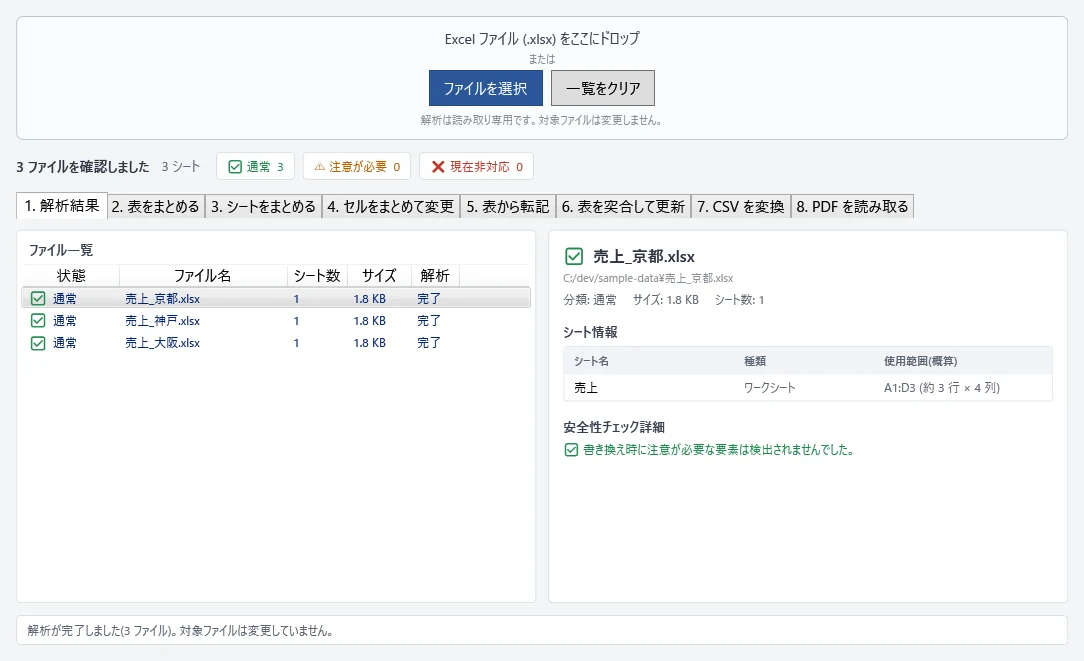
最初に手をつけたのは、変換機能ではなく解析機能のほうだった。数式・結合セル・ピボット・入力規則・条件付き書式といった「触ると壊れる可能性があるもの」を先に検出して、危ないファイルはそもそも処理させない。入力したExcelファイルはどの機能でも一切変更せず、値を書き換える機能でも必ず別名の新しいファイルを作る。この「壊さない」を土台に据えてから、機能を足していった。
実際の画面もこの解析結果から始まり、上に並んだタブがそのまま用意した機能の一覧になっている。
市場を調べ直したら、PDF案件がいちばん多かった
ある程度動くようになった段階で、そもそも自分が作っているものが市場と噛み合っているのかを確かめたくなり、日本のクラウドソーシング市場をもう一度調べることにした。
対象は日本国内、CrowdWorks / Lancersが中心で、期間は2026年6月から8月29日までの公開案件。そこから重複と内容不明のもの、「Excel」が単にスキル欄へ入っているだけのものを除いていくと、65件が残った。プラットフォーム全体の公式統計ではなく、公開されている検索結果から自分で作ったサンプルという位置づけになる。
日本のクラウドソーシング案件の内訳(再分類サンプル65件)
CrowdWorks / Lancers中心。2026年6月〜8月29日の公開案件から作成。
- PDF・画像 → Excel18件 / 27.7%
- VBA・Excel専用システム17件 / 26.2%
- Web調査 → Excel12件 / 18.5%
- 継続事務・EC・バックオフィス11件 / 16.9%
- Excel / CSV加工6件 / 9.2%
- 特殊1件 / 1.5%
分類は筆者の判断による。公式統計ではない。
いちばん大きな塊は「PDF・画像 → Excel」で、自分が最初に想定していた「Excel / CSV加工」はその3分の1ほどしかない。作りたいと思っていたものと、実際に募集されているものがずれていたことになる。PDFに手を出さない限り、この一番大きな塊には触れられない。
スキャンPDFのOCRまで対応した
ひとくちにPDFと言っても、今回扱うものは大きく2種類に分かれる。
- born-digital PDF — パソコンで作られた、文字情報を持つPDF
- スキャンPDF — 紙を取り込んだ、ただの画像
前者は文字をそのまま取り出せるが、後者はOCRを通さないと1文字も読めない。実際の募集にも、後者のようにOCRが必要なPDFが含まれていた。
OCRだけならクラウドサービスを使えばすぐ手に入る。それでも使わなかったのは、帳票に氏名や住所、取引先名、金額といった情報が含まれることがあるからで、受託作業として扱うなら外部サービスへ送らずに処理できる選択肢を持っておきたかった。OCRエンジンとモデルをアプリ側へ同梱する形にした結果、使う側から見ると次のようになる。
- PDFも画像も外部へ送らない。読み取りはPCの中で終わる
- Microsoft Excelもインストールしなくていい
- 実行時にモデルをダウンロードしない。Python、Java、pip、PATH設定もいらない
- モデルは本体とは別配布のOffline OCR Packを置くだけ
ネットワークに繋がっていない端末でも、そのまま動く。
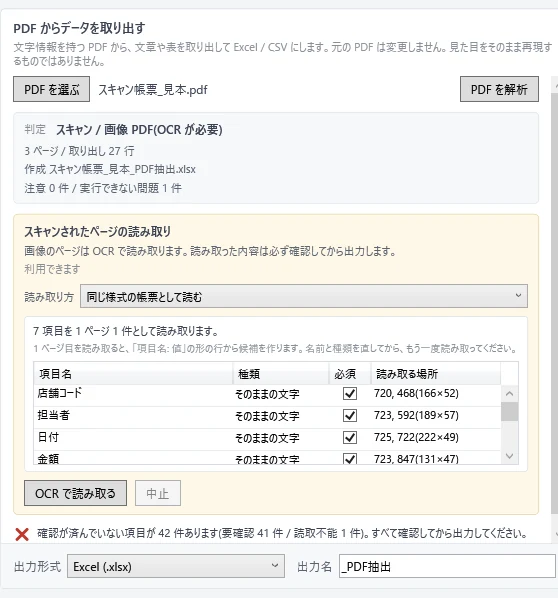
読み取り方も画面で選ぶ。同じ様式の帳票として読むときは、1ページ目から作った項目の候補を見ながら名前と種類を直し、そのうえで全ページの読み取りに進む。
最終的に対応した範囲は次のとおり。
- Workbookの互換性・安全性解析
- 複数Excel表の縦結合
- 複数Excelから選んだシートを1つのWorkbookへ集約
- 複数ファイル / シートのセル一括変更
- Excel / CSVをデータ元にした完全一致キー転記
- 表同士を突合して既存行を更新
- CSVの形式変換(列名変更 / 並べ替え / 除外 / 複製 / 固定値 / 空欄、UTF-8 BOM・UTF-8・CP932、引用符制御、CRLF)
- 処理設定(レシピ)の保存・再利用
- born-digital PDF
- スキャンPDF
- 罫線あり / なしのスキャン表
- 同じ様式の帳票(Fixed Form)
- checkbox / mark
- 傾き補正(deskew)
- 混在PDFのページ別自動判定
- OCR結果の確認・修正
- 元PDF画像とbboxを見ながらの確認
- Excel / CSV出力
- PDFの処理設定(レシピ)
- Offline OCR Pack
- 完全オフライン動作
OCRの数字は「精度」だけでは見ない
OCRは必ず間違えるので、「認識率を100%にする」ことは最初から目標にしていない。目指したのは、怪しいものを人の確認へ送り、間違ったまま自動で確定してしまうものを0にすることだった。
そのため、この記事には似ているようで意味の違う数字がいくつか出てくる。
- 完全一致率 — 読み取った値が正解と1文字も違わなかった割合
- 自動確定率 — 人が見なくてよいとツールが判断した割合
- 人が確認 — 残り。目で見て確定させる割合
- 誤って自動確定 — 間違っているのに自動確定してしまった件数。ここを0にしたい
完全一致率が100%に届かなくても、間違いがきちんと確認へ回っていれば出力そのものは壊れない。逆に言えば、誤って自動確定した1件のほうが、完全一致率の数ポイントよりも重い。
できあがったものの数字
- 1,027
- テスト通過数(全件PASS)
- 0
- 誤って自動確定した件数(全fixture / 全シナリオ)
- 100%
- 読み取り対象項目の網羅率
OCRで作り込んだのは「間違いを見つけられること」
この「間違いに気付ける形」は、一度で作れたわけではない。むしろ最初に作ったものは、自分で思っていたほど役に立たなかった。
元のPDFを見ないと、合っているか判断できない
最初に作った確認画面は、OCRが読み取った文字だけを一覧にするものだった。読み取り結果さえ並べておけば、人が目で見て正誤を判断できるだろうと考えていた。
実際に使ってみると、これがまるで役に立たない。「スキャンした見本1架空」という文字列を見せられても、元の紙に何と書いてあったのかが分からない以上、正しいかどうか判断のしようがない。認識モデルを2つ使っているのだから片方が間違えれば気付けるはずだ、とも思っていたが、両方が同じように間違えることもある。
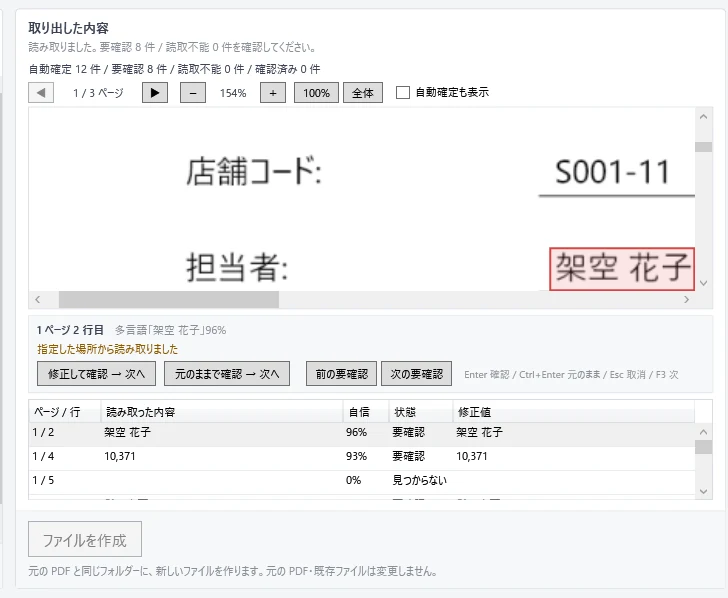
原文と見比べられなければ、確認作業はそもそも成立しない。選んだ項目のページ画像を表示して読み取った位置を赤い枠(bbox)で囲む形に作り直し、文字が小さすぎるときは読める大きさまで自動で寄るようにした。
「まとめて確認済み」は安全設計の抜け道だった
一覧に「表示中をすべて確認済みにする」というボタンを付けていた時期がある。件数が多いときには便利で、自分でもよく押していた。
落ち着いて考えると、これは自分で用意した安全装置を自分で無効化するためのボタンだった。未確認の項目が1件でも残っていれば出力させない、という仕組みをわざわざ作っておきながら、その隣に「全部確認したことにする」を並べていたことになる。原文と見比べていなくても押せてしまう以上、確認を必須にした意味がない。
ボタンは削除して、いまは「修正して確認 → 次へ」「元のままで確認 → 次へ」で1件ずつ進める形にしている。未確認を飛び越える手段は残していない。
読めなかった項目が、静かに消えていた
見つけたなかで、いちばん気持ちが悪かったのがこれだった。
帳票から項目を読み取るとき、OCRの検出がその領域を拾えないことがある。誤読であれば読み取り結果として確認画面に出てくるので、人が見て直せる。ところが検出そのものに失敗した項目は、確認画面にも出力にも現れないまま、結果からまるごと消えていた。
この2つは似ているようで質がまったく違う。誤読は「間違いがある」ことが見えている状態だが、検出漏れのほうは「そこに何かがあった」こと自体が分からない。出力されたExcelを眺めても、欠けていると気付く手がかりが残らない。実測してみると、帳票の813項目のうち89件がこの状態だった。
対処として、「指定した項目 → 読み取り結果」を必ず1対1で対応させるようにした。読み取れなかった項目も消さずにMissing / Unreadableとして残し、位置には指定した領域をそのまま使うので、確認画面で元のページの同じ場所を見ながら手で入力できる。指定した項目の数と確認に出る件数は必ず一致し、Expected field coverageは100%になる。
表のセルにも同じ問題があった。罫線から作った格子のうち、文字が1つも割り当たらなかったセルは黙って空欄として出力されていた。こちらはセルに黒い画素があるかどうかを測って切り分け、文字があるのに読めなかったセルだけを「読取不能」として人へ回し、もともと空のセルはそのまま空欄として出している。
傾き補正の向きが逆だった
一連の作業のなかで、いちばん手痛かったのがこれだった。
スキャンされた紙はたいてい少し傾いているので、読む前に傾きを直す(deskew)処理を入れている。角度の推定自体はうまくいっていて、実測で平均誤差0.37度、最大でも0.53度。この数字だけ見れば十分な精度が出ていた。
にもかかわらず、傾いた罫線表の成績がいつまで経っても上がらない。推定は当たっているのだから原因は別のところにあるはずだ、と思い込んだまま、しばらく見当違いの場所を調べ続けていた。
行き詰まって補正後の画像そのものを確認したところ、傾き2度と正しく測れているページで、罫線が1本も検出できていないことに気付いた。試しに逆向きへ回してみると、22行3列の格子があっさり出てくる。
rotate  -1.98: rows=0  cols=0    ← 実際にやっていた向き
rotate  +1.98: rows=22 cols=3    ← 正しい向き
補正しているつもりで、傾きを倍にしていた。
角度の推定値だけを見ている限りどこにも異常がないので、中間の数字を確認して満足していた分だけ発見が遅れたことになる。向きを直した結果が次のとおり。
傾き2度の罫線表(補正の向きを直す前と後)
セル単位の完全一致率。誤って自動確定した件数は101件から0件になった。
読み取りの成績が大きく変わっただけでなく、誤って自動確定していたセルが101件から0件になった。それ以前に「傾いた表は実用にならないので止める」と判断して報告していた数値も、遡ってみればすべてこの間違いが原因だった。
中間の推定値が正しいことと、補正が正しく効いていることは別だ。 角度の誤差だけで判断せず、補正後の画像から罫線が拾えるかどうかまで確認していれば、その場で気付けたはずだった。
向きを直してからは、罫線が斜めに走ったまま取り込まれたページでも、読み取った値がきちんと揃うようになった。
PP-OCRv5は比較したうえで採用しなかった
OCRエンジンにはPaddleOCRを使っている。開発の途中でPP-OCRv5が使えることが分かり、新しいほうが当然よいだろうと考えて比較してみたのだが、結局は採用を見送った。
完全一致率で見ると、帳票480項目のうち変わったのは1項目だけでほとんど差がない。その一方で処理時間は1ページあたり1.6〜1.9秒に対して3.7〜4.6秒と、2倍以上かかっていた。原因はPaddle2ONNXがv5のモデルを変換できず、ONNX Runtimeを経由せずネイティブ実行に落ちることだった。
面白かったのは、v5に期待していた精度差のほうが別の理由で埋まっていたことだ。Paddle Inferenceのバージョンを2.6.1から3.3.1へ上げただけで、同じv4モデルのまま帳票の完全一致率は80.2%から99.0%になり、検出漏れも4件から0件になった。モデルを新しくする前に、土台のバージョンを疑うべきだったということになる。
最終的な構成は次のとおり。
- 多言語モデル
ch_PP-OCRv4_rec - 日本語モデル
japan_PP-OCRv4_rec - この2つによる二重読み
- Paddle Inference 3.3.1
- ONNX Runtime
- 300dpi
2つのモデルで同じ場所を読み、結果を突き合わせている。片方だけでは、かな漢字か英数字コードのどちらかが必ず崩れることを実測で確かめたうえでの構成だ。
ただし「両方が一致したから正しい」とは限らない。同系統のモデルなので、同じ字形の取り違えは共通して起きる。実際にS001-24を両方ともSO01-24(0をO)と読み、自信98%で一致していた例があった。そのため、一致していても形が怪しいものは自動確定しない仕組みを足してある。値を勝手に書き換えることはせず、人の確認へ回すだけだ。
実案件相当のシナリオで通した
技術的なfixtureをいくら通しても、実際の案件で使えるかどうかまでは分からない。クラウドソーシングで見かけた作業の型を、第三者の文書は一切使わず、すべて架空のデータを生成コードから作って再現することにした。
実案件相当シナリオの結果
濃い棒が完全一致率、薄い棒が自動確定率。残りは人が確認する。
誤って自動確定した件数は、A / B / C / D / Fすべてで0件。
シナリオEだけは性質が違っていて、混在PDF100ページを文字情報のあるページとスキャンページへ自動で仕分ける試験になっている。ページの取りこぼしは0件だったが、構造上どうしても安全に1つの表へまとめられない組み合わせのときは、無理にまとめず出力を止めるようにしてある。
fixtureでの代表値も並べておく。
| 対象 | 完全一致率 |
|---|---|
| 罫線ありスキャン表(通常) | 94.3% |
| 罫線ありスキャン表(傾き2度) | 88.9% |
| 罫線ありスキャン表(劣化) | 86.1% |
| 罫線なしスキャン表 | 98.3% |
| 帳票(通常) | 99.0% |
| 帳票(位置ずれ) | 94.2% |
| 帳票(倍率違い) | 99.2% |
| 帳票(傾き±2度) | 94.2% |
対象によって完全一致率にはかなり幅がある。それでも全fixture・全シナリオを通して誤って自動確定した件数は0件で、読み違えた分はすべて人の確認へ回っていた。狙っていたのは、まさにこの形だった。テストは1,027件すべてPASS、ビルドは警告0・エラー0。
完成してから、もう一度市場を調べた
ひととおり動くようになったところで、最初に調べた65件をもう一度見直し、いまのツールで実際に受けられるかどうかで分類してみた。
- A — 現在のツールでかなり素直に対応できる
- B — 条件確認や少しの人手込みなら現実的
- C — ツールは一部役立つが、案件全体としては難しい
- D — VBAや専用システムの開発で、そもそも守備範囲が違う
65件を現在のツールで対応できるかで分類
- A 素直に対応できる9件 / 13.8%
- B 条件次第で現実的12件 / 18.5%
- C 一部しか役立たない27件 / 41.5%
- D VBA・専用システム17件 / 26.2%
VBA・専用システムの17件を除いた48件で見ると、A + Bは20件・41.7%になる。
今回の65件ではA + Bが21件で、保守的に見ても実用になるのは全体の25〜32%程度という感触だった。ただしこの数字は、分野によってかなり違ってくる。
分野別に見たA + Bの割合
PDF関連18件の内訳はA 7件・B 8件・C 3件。
狙って作ったPDF案件とExcel / CSV加工は8割を超えていて、ここは意図したとおりの結果になった。VBA案件を除いた市場、そして市場全体と広げていくにつれて、対応できる割合は順に下がっていく。
Web調査系がゼロなのは、ツールの出来とは関係がない。「Webを見て情報を集めてくる」作業である以上、Excel / PDFを処理する道具では最初から手が出ないというだけの話だ。
万能なツールにはなっていない。強い領域と弱い領域が、はっきり分かれている。
技術的にできることと、良い案件があることは別だった
ここまでで、技術的に受けられる仕事の範囲はたしかに広がった。それでも、対応できることと、その案件を実際に受けたいと思えるかどうかは別だった。
調査中に見かけた募集をいくつか挙げておく。相場を示す統計ではなく、こういう条件のものが実在した、という例として読んでほしい。
| 作業量 | 報酬 |
|---|---|
| 742ページ / 約1,484項目 | 1,730円 |
| 1,200ページ超 / 約2,500項目 | 約2,900〜3,000円 |
| 116ページ | 220円 |
ツールで処理できるとしても、確認作業まで消えてなくなるわけではない。シナリオCのように人が4割を確認する必要がある帳票なら、数百項目を目で見て直すことになる。それで1,730円という条件は、さすがに厳しい。
応募人数のほうも同じく実例として挙げておくと、PDFアンケートの案件で249応募、レシートをExcelにする案件では799応募だった。799人が応募している案件に、ツールを持っているというだけで通るとは限らない。
今回探した範囲では、低単価だったり応募が集中していたりで、実際に応募したいと思える案件はそこまで多くなかった。そのうえで対応できそうなものを選び、CrowdWorksへ3件応募してみている。結果はまだ分からない。3件だけで市場を語れるわけもないが、作ったツールを「開発物」のまま終わらせず、実際の案件へ持ち出すところまでは進められた。
まとめ
Excel / CSVの処理から始めて、市場調査をきっかけにPDF・スキャン帳票のOCRまで広げてきた。技術的には当初想定していたよりずっと遠くまで来ていて、スキャンされた帳票をPCの中だけで読み取り、Excel / CSVにするところまでは辿り着いている。
振り返ってみると、学びが大きかったのは達成した数字よりも、途中で見つけた間違いのほうだった。確認画面にOCRの文字しか出していなかったこと、まとめて確認できる抜け道を自分で作っていたこと、読めなかった項目が静かに消えていたこと、そして傾き補正の向きが逆だったこと。どれも「動いているように見える」状態で潜んでいて、指標の上ではむしろ順調に見えていた。とりわけ傾き補正は、推定した角度そのものが正しかったせいで、中間の数字を眺めている限りどこにも異常がなかった。補正した後の実物を確認していなかった、というだけの話だ。
市場のほうは、思っていたより厳しかった。Excel作業の自動化ができる道具を持っていることと、その道具で受けたい仕事が大量にあることは、まったく別だった。
だから次に何を足すかも、もう想像だけでは決めない。実際の案件を見て、同じ理由で何度も取りこぼす仕事が見えてきたときに、その部分だけを広げていくつもりだ。
少なくとも、PDFとスキャン帳票をオフラインで処理できる道具は、もう手元にある。
ツールのコードはexcel-batch-toolとしてGitHubに公開している(MIT License、開発コードネームで、正式な製品名は未定)。